Domain traffic-tool.de kaufen?
Wir ziehen mit dem Projekt
traffic-tool.de um.
Sind Sie am Kauf der Domain
traffic-tool.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain traffic-tool.de kaufen?
Was sind die potenziellen Vorteile und Risiken von Web-Crawling für die Datenextraktion und -analyse?
Potenzielle Vorteile von Web-Crawling für die Datenextraktion und -analyse sind die Möglichkeit, große Mengen an Daten schnell und effizient zu sammeln, sowie die Automatisierung von Prozessen. Risiken sind unter anderem rechtliche Probleme aufgrund von Urheberrechtsverletzungen und die Gefahr von fehlerhaften oder veralteten Datenquellen. Es ist wichtig, ethische Richtlinien zu beachten und sicherzustellen, dass die gesammelten Daten korrekt und zuverlässig sind. **
Wie kann man Datenextraktion effizient und sicher durchführen?
Datenextraktion kann effizient durch den Einsatz von Automatisierungstools und Skripten erfolgen. Um die Sicherheit zu gewährleisten, sollten sensible Daten verschlüsselt und Zugriffsrechte streng kontrolliert werden. Zudem ist es wichtig, regelmäßige Backups anzulegen, um Datenverlust zu vermeiden. **

Ähnliche Suchbegriffe für Datenextraktion
Top-Angebote
Produkte zum Begriff Datenextraktion:
-
Ontologiebasierte Datenextraktion in den Inhalten zu Stipendien, Taschenbuch von Anna Yushtina, Verlag Unser Wissen, 978-620-8-82001-5Ontologiebasierte Datenextraktion In Den Inhalten Zu Stipendien, Taschenbuch Von Anna Yushtina, Verlag Unser Wissen, 978-620-8-82001-5, Seitenanzahl: 7635,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Bamberg, Günter: StatistikStatistik , Eine Einführung für Wirtschafts- und Sozialwissenschaftler , Erste-Hilfe-Ausrüstung > Sicherheit , Auflage: 19., überarbeitete Auflage, Erscheinungsjahr: 20220523, Produktform: Kartoniert, Titel der Reihe: De Gruyter Studium##, Autoren: Bamberg, Günter~Baur, Franz~Krapp, Michael, Auflage: 22019, Auflage/Ausgabe: 19., überarbeitete Auflage, Seitenzahl/Blattzahl: 322, Themenüberschrift: BUSINESS & ECONOMICS / Statistics, Keyword: Deskriptive Statistik; Wahrscheinlichkeitsrechnung; Verteilungen; Induktive Statistik; Signifikanztest; Zeitreihen, Fachschema: Ökonometrie~Statistik / Wirtschaftsstatistik~Wirtschaftsstatistik, Fachkategorie: Betriebswirtschaft und Management, Bildungszweck: für die Hochschule, Warengruppe: HC/Betriebswirtschaft, Fachkategorie: Ökonometrie und Wirtschaftsstatistik, Thema: Verstehen, Text Sprache: ger, Seitenanzahl: X, Seitenanzahl: 322, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Verlag: de Gruyter Oldenbourg, Verlag: de Gruyter Oldenbourg, Verlag: De Gruyter Oldenbourg, Länge: 238, Breite: 170, Höhe: 19, Gewicht: 566, Produktform: Kartoniert, Genre: Sozialwissenschaften/Recht/Wirtschaft, Genre: Sozialwissenschaften/Recht/Wirtschaft, Vorgänger: 2159554, Vorgänger EAN: 9783110495706 9783486716511 9783486702583 9783486590883 9783486585650, Alternatives Format EAN: 9783110759402 9783110759327, Herkunftsland: DEUTSCHLAND (DE), Katalog: deutschsprachige Titel, Katalog: Gesamtkatalog, Katalog: Kennzeichnung von Titeln mit einer Relevanz > 30, Katalog: Lagerartikel, Book on Demand, ausgew. Medienartikel, Relevanz: 0060, Tendenz: -1, Unterkatalog: AK, Unterkatalog: Bücher, Unterkatalog: Hardcover, Unterkatalog: Lagerartikel, WolkenId: 162715929,95 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Vision-basierte Deep-Web-Datenextraktion für Web-Dokument-Clustering, Taschenbuch von M. Lavanya, Verlag Unser Wissen, 978-620-5-02342-6Vision-basierte Deep-web-datenextraktion Für Web-dokument-clustering, Taschenbuch Von M. Lavanya, Verlag Unser Wissen, 978-620-5-02342-6, Seitenanzahl: 20079,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
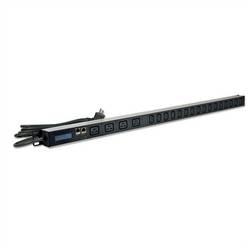
GUDE 8311-16 metered PDU, 20x, Mess-/Auswertung, Differenzstrom-Überwachung Typ A20-fach metered PDU mit integrierten Mess-/Auswertungsmöglichkeiten mit Differenzstrom-Überwachung Typ A für TCP/IP-Netzwerke 4 Lastausgänge (Kaltgeräte C19) auf der Frontseite . 16 Lastausgänge (Kaltgeräte C13) auf der Frontseite . Messung von Strom, Spannung, Phasenwinkel, Leistungsfaktor, Frequenz, Wirk-, Schein- und Blindleistung. 2 Energiezähler, ein Zähler zählt dauerhaft, der andere Zähler ist rücksetzbar. Differenzstrom-Überwachung Typ A. Beleuchtete zweizeilige LCD-Anzeige. Anschluss für optionale Sensoren zur Umgebungsüberwachung (Temperatur, Luftfeuchtigkeit und Luftdruck). Einfache und flexible Konfiguration über Webbrowser, Windows- oder Linux-Programm. Firmware-Update im laufenden Betrieb über Ethernet möglich. IPv6-ready. HTTP/HTTPS, E-Mail (SSL, STARTTLS), DHCP, Syslog. SNMPv1, v2c, v3 (Get/Traps). TLS 1.0, 1.1, 1.2. Radius- und Modbus TCP-Protokoll wird unterstützt. Konfiguration und Steuerung über Telnet. Geringer Eigenverbrauch. Entwickelt und produziert in Deutschland .605,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter

-
Wie kann man Datenextraktion effizient und präzise durchführen?
Durch die Verwendung von automatisierten Tools und Algorithmen, um große Datenmengen schnell zu analysieren und extrahieren. Durch die regelmäßige Überprüfung und Aktualisierung der Extraktionsprozesse, um sicherzustellen, dass die Daten korrekt und aktuell sind. Durch die Einhaltung von Datenschutzrichtlinien und -vorschriften, um die Integrität und Sicherheit der extrahierten Daten zu gewährleisten. **
-
Wie kann man Datenextraktion effizient und genau durchführen?
Um Datenextraktion effizient und genau durchzuführen, sollte man zunächst klare Ziele und Kriterien für die Extraktion festlegen. Anschließend ist es wichtig, geeignete Tools und Techniken zu verwenden, um die Daten systematisch zu extrahieren. Zuletzt sollte die Extraktion regelmäßig überprüft und optimiert werden, um die Genauigkeit und Effizienz sicherzustellen. **
-
Was sind die Vorteile und Herausforderungen des Web-Crawlings für die Datenextraktion und Analyse von Internetinhalten?
Die Vorteile des Web-Crawlings für die Datenextraktion und Analyse von Internetinhalten sind die Möglichkeit, große Mengen an Daten schnell und effizient zu sammeln, sowie die Fähigkeit, Informationen aus verschiedenen Quellen zu aggregieren und zu analysieren. Die Herausforderungen liegen in der Notwendigkeit, mit der ständigen Veränderung und Aktualisierung von Webinhalten Schritt zu halten, sowie in der Gefahr von Fehlinformationen und ungenauen Daten aufgrund von fehlerhaften Crawling-Algorithmen oder unzuverlässigen Quellen. **
-
Wie kann man Datenextraktion effizient und zuverlässig durchführen? Welche Tools und Methoden eignen sich am besten zur Datenextraktion aus unterschiedlichen Quellen?
Um Datenextraktion effizient und zuverlässig durchzuführen, sollte man zunächst klare Ziele definieren und die benötigten Datenquellen identifizieren. Anschließend können automatisierte Tools wie Web Scraping-Software oder Datenbankabfragen verwendet werden, um die Daten extrahieren. Zuletzt ist es wichtig, die extrahierten Daten zu überprüfen und zu validieren, um sicherzustellen, dass sie korrekt und vollständig sind. **

Was sind die Vorteile von Web-Crawling für die Datenextraktion?
Web-Crawling ermöglicht die automatische Extraktion von großen Mengen an Daten aus dem Internet. Es spart Zeit und Ressourcen, da Informationen schnell und effizient gesammelt werden können. Zudem können mithilfe von Web-Crawling aktuelle und relevante Daten für Analysen und Entscheidungsfindungen gewonnen werden. **
Welche Funktionen und Möglichkeiten bietet ein typisches Analyse-Tool zur Auswertung großer Datenmengen?
Ein typisches Analyse-Tool bietet Funktionen zur Datenaufbereitung, -visualisierung und -interpretation. Es ermöglicht die Identifizierung von Trends, Mustern und Zusammenhängen in großen Datenmengen. Zudem können mithilfe des Tools Prognosen und Vorhersagen getroffen werden. **
Top-Angebote
Produkte zum Begriff Datenextraktion:
-
Web-Datenextraktion der Kompetenzen von Universitätsmitarbeitern, Taschenbuch von Edin Zildzo, Verlag Unser Wissen, 978-620-9-77521-5Web-datenextraktion Der Kompetenzen Von Universitätsmitarbeitern, Taschenbuch Von Edin Zildzo, Verlag Unser Wissen, 978-620-9-77521-5, Seitenanzahl: 8448,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Ontologiebasierte Datenextraktion in den Inhalten zu Stipendien, Taschenbuch von Anna Yushtina, Verlag Unser Wissen, 978-620-8-82001-5Ontologiebasierte Datenextraktion In Den Inhalten Zu Stipendien, Taschenbuch Von Anna Yushtina, Verlag Unser Wissen, 978-620-8-82001-5, Seitenanzahl: 7635,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Bamberg, Günter: StatistikStatistik , Eine Einführung für Wirtschafts- und Sozialwissenschaftler , Erste-Hilfe-Ausrüstung > Sicherheit , Auflage: 19., überarbeitete Auflage, Erscheinungsjahr: 20220523, Produktform: Kartoniert, Titel der Reihe: De Gruyter Studium##, Autoren: Bamberg, Günter~Baur, Franz~Krapp, Michael, Auflage: 22019, Auflage/Ausgabe: 19., überarbeitete Auflage, Seitenzahl/Blattzahl: 322, Themenüberschrift: BUSINESS & ECONOMICS / Statistics, Keyword: Deskriptive Statistik; Wahrscheinlichkeitsrechnung; Verteilungen; Induktive Statistik; Signifikanztest; Zeitreihen, Fachschema: Ökonometrie~Statistik / Wirtschaftsstatistik~Wirtschaftsstatistik, Fachkategorie: Betriebswirtschaft und Management, Bildungszweck: für die Hochschule, Warengruppe: HC/Betriebswirtschaft, Fachkategorie: Ökonometrie und Wirtschaftsstatistik, Thema: Verstehen, Text Sprache: ger, Seitenanzahl: X, Seitenanzahl: 322, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Verlag: de Gruyter Oldenbourg, Verlag: de Gruyter Oldenbourg, Verlag: De Gruyter Oldenbourg, Länge: 238, Breite: 170, Höhe: 19, Gewicht: 566, Produktform: Kartoniert, Genre: Sozialwissenschaften/Recht/Wirtschaft, Genre: Sozialwissenschaften/Recht/Wirtschaft, Vorgänger: 2159554, Vorgänger EAN: 9783110495706 9783486716511 9783486702583 9783486590883 9783486585650, Alternatives Format EAN: 9783110759402 9783110759327, Herkunftsland: DEUTSCHLAND (DE), Katalog: deutschsprachige Titel, Katalog: Gesamtkatalog, Katalog: Kennzeichnung von Titeln mit einer Relevanz > 30, Katalog: Lagerartikel, Book on Demand, ausgew. Medienartikel, Relevanz: 0060, Tendenz: -1, Unterkatalog: AK, Unterkatalog: Bücher, Unterkatalog: Hardcover, Unterkatalog: Lagerartikel, WolkenId: 162715929,95 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Was sind die potenziellen Vorteile und Risiken von Web-Crawling für die Datenextraktion und -analyse?
Potenzielle Vorteile von Web-Crawling für die Datenextraktion und -analyse sind die Möglichkeit, große Mengen an Daten schnell und effizient zu sammeln, sowie die Automatisierung von Prozessen. Risiken sind unter anderem rechtliche Probleme aufgrund von Urheberrechtsverletzungen und die Gefahr von fehlerhaften oder veralteten Datenquellen. Es ist wichtig, ethische Richtlinien zu beachten und sicherzustellen, dass die gesammelten Daten korrekt und zuverlässig sind. **
-
Wie kann man Datenextraktion effizient und sicher durchführen?
Datenextraktion kann effizient durch den Einsatz von Automatisierungstools und Skripten erfolgen. Um die Sicherheit zu gewährleisten, sollten sensible Daten verschlüsselt und Zugriffsrechte streng kontrolliert werden. Zudem ist es wichtig, regelmäßige Backups anzulegen, um Datenverlust zu vermeiden. **
-
Wie kann man Datenextraktion effizient und präzise durchführen?
Durch die Verwendung von automatisierten Tools und Algorithmen, um große Datenmengen schnell zu analysieren und extrahieren. Durch die regelmäßige Überprüfung und Aktualisierung der Extraktionsprozesse, um sicherzustellen, dass die Daten korrekt und aktuell sind. Durch die Einhaltung von Datenschutzrichtlinien und -vorschriften, um die Integrität und Sicherheit der extrahierten Daten zu gewährleisten. **
-
Wie kann man Datenextraktion effizient und genau durchführen?
Um Datenextraktion effizient und genau durchzuführen, sollte man zunächst klare Ziele und Kriterien für die Extraktion festlegen. Anschließend ist es wichtig, geeignete Tools und Techniken zu verwenden, um die Daten systematisch zu extrahieren. Zuletzt sollte die Extraktion regelmäßig überprüft und optimiert werden, um die Genauigkeit und Effizienz sicherzustellen. **
Ähnliche Suchbegriffe für Datenextraktion
-
Vision-basierte Deep-Web-Datenextraktion für Web-Dokument-Clustering, Taschenbuch von M. Lavanya, Verlag Unser Wissen, 978-620-5-02342-6Vision-basierte Deep-web-datenextraktion Für Web-dokument-clustering, Taschenbuch Von M. Lavanya, Verlag Unser Wissen, 978-620-5-02342-6, Seitenanzahl: 20079,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
GUDE 8311-16 metered PDU, 20x, Mess-/Auswertung, Differenzstrom-Überwachung Typ A20-fach metered PDU mit integrierten Mess-/Auswertungsmöglichkeiten mit Differenzstrom-Überwachung Typ A für TCP/IP-Netzwerke 4 Lastausgänge (Kaltgeräte C19) auf der Frontseite . 16 Lastausgänge (Kaltgeräte C13) auf der Frontseite . Messung von Strom, Spannung, Phasenwinkel, Leistungsfaktor, Frequenz, Wirk-, Schein- und Blindleistung. 2 Energiezähler, ein Zähler zählt dauerhaft, der andere Zähler ist rücksetzbar. Differenzstrom-Überwachung Typ A. Beleuchtete zweizeilige LCD-Anzeige. Anschluss für optionale Sensoren zur Umgebungsüberwachung (Temperatur, Luftfeuchtigkeit und Luftdruck). Einfache und flexible Konfiguration über Webbrowser, Windows- oder Linux-Programm. Firmware-Update im laufenden Betrieb über Ethernet möglich. IPv6-ready. HTTP/HTTPS, E-Mail (SSL, STARTTLS), DHCP, Syslog. SNMPv1, v2c, v3 (Get/Traps). TLS 1.0, 1.1, 1.2. Radius- und Modbus TCP-Protokoll wird unterstützt. Konfiguration und Steuerung über Telnet. Geringer Eigenverbrauch. Entwickelt und produziert in Deutschland .605,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
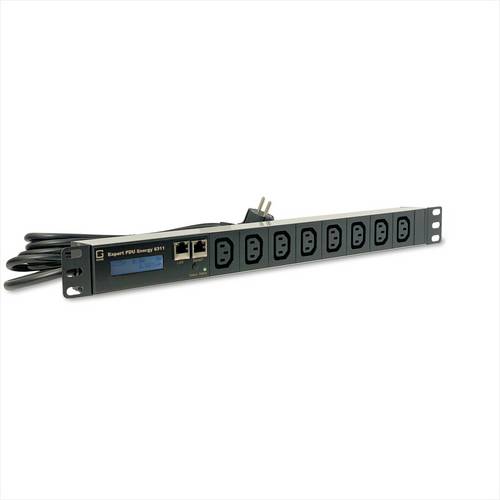
GUDE 8311-4 metered PDU, 8xC13, Mess-/Auswertung, Differenzstrom-Überwachung Typ A, 1,5m8-fach metered PDU mit integrierten Mess-/Auswertungsmöglichkeiten für TCP/IP-Netzwerke mit Differenzstrom-Überwachung Typ A 8 Lastausgänge (C13) auf der Frontseite . Messung von Strom, Spannung, Phasenwinkel, Leistungsfaktor, Frequenz, Wirk-, Schein- und Blindleistung. 2 Energiezähler, ein Zähler zählt dauerhaft, der andere Zähler ist rücksetzbar. Differenzstrom-Überwachung Typ A. Beleuchtete zweizeilige LCD-Anzeige. Anschluss für optionale Sensoren zur Umgebungsüberwachung (Temperatur, Luftfeuchtigkeit und Luftdruck). Einfache und flexible Konfiguration über Webbrowser, Windows- oder Linux-Programm. Firmware-Update im laufenden Betrieb über Ethernet möglich. IPv6-ready. HTTP/HTTPS, E-Mail (SSL, STARTTLS), DHCP, Syslog. SNMPv1, v2c, v3 (Get/Traps). TLS 1.0, 1.1, 1.2. Radius- und Modbus TCP-Protokoll wird unterstützt. Konfiguration und Steuerung über Telnet. Geringer Eigenverbrauch. Entwickelt und produziert in Deutschland .415,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Differentialgleichungen, Optimierung und Ungleichungen, Wahrscheinlichkeitsrechnung und Statistik, Rechenanlagen und ihre Programmierung, GebundeneDifferentialgleichungen, Optimierung Und Ungleichungen, Wahrscheinlichkeitsrechnung Und Statistik, Rechenanlagen Und Ihre Programmierung, Gebundene Ausgabe Von Lothar Collatz,julius Albrecht, De Gruyter, 978-3-11-274050-7, Seitenanzahl: 141165,99 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Was sind die Vorteile und Herausforderungen des Web-Crawlings für die Datenextraktion und Analyse von Internetinhalten?
Die Vorteile des Web-Crawlings für die Datenextraktion und Analyse von Internetinhalten sind die Möglichkeit, große Mengen an Daten schnell und effizient zu sammeln, sowie die Fähigkeit, Informationen aus verschiedenen Quellen zu aggregieren und zu analysieren. Die Herausforderungen liegen in der Notwendigkeit, mit der ständigen Veränderung und Aktualisierung von Webinhalten Schritt zu halten, sowie in der Gefahr von Fehlinformationen und ungenauen Daten aufgrund von fehlerhaften Crawling-Algorithmen oder unzuverlässigen Quellen. **
-
Wie kann man Datenextraktion effizient und zuverlässig durchführen? Welche Tools und Methoden eignen sich am besten zur Datenextraktion aus unterschiedlichen Quellen?
Um Datenextraktion effizient und zuverlässig durchzuführen, sollte man zunächst klare Ziele definieren und die benötigten Datenquellen identifizieren. Anschließend können automatisierte Tools wie Web Scraping-Software oder Datenbankabfragen verwendet werden, um die Daten extrahieren. Zuletzt ist es wichtig, die extrahierten Daten zu überprüfen und zu validieren, um sicherzustellen, dass sie korrekt und vollständig sind. **
-
Was sind die Vorteile von Web-Crawling für die Datenextraktion?
Web-Crawling ermöglicht die automatische Extraktion von großen Mengen an Daten aus dem Internet. Es spart Zeit und Ressourcen, da Informationen schnell und effizient gesammelt werden können. Zudem können mithilfe von Web-Crawling aktuelle und relevante Daten für Analysen und Entscheidungsfindungen gewonnen werden. **
-
Welche Funktionen und Möglichkeiten bietet ein typisches Analyse-Tool zur Auswertung großer Datenmengen?
Ein typisches Analyse-Tool bietet Funktionen zur Datenaufbereitung, -visualisierung und -interpretation. Es ermöglicht die Identifizierung von Trends, Mustern und Zusammenhängen in großen Datenmengen. Zudem können mithilfe des Tools Prognosen und Vorhersagen getroffen werden. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.